Toutes vos données visuelles. Un seul endroit.
Agrégez, organisez et explorez des milliards d'images et de vidéos depuis n'importe quelle source. Un référentiel unifié pour toutes vos données de vision par ordinateur.

Comment ça fonctionne en coulisses
Se connecte à S3, GCP ou Azure. Ingère tout format d'image ou vidéo. Indexe tout pour que vous puissiez le requêter ensuite.
AWS S3GCPAzurefrom picsellia import Client
client = Client()
datalake = client.get_datalake()
# Upload with metadata
datalake.upload_data(
filepaths="./images/*.jpg",
tags=["production", "batch-42"],
metadata={"reference": "factory-A"}
)
# Query with filters
data = datalake.list_data(
tags=["production"]
)# Query with tags
data = datalake.list_data(
tags=["defects"]
)
# ✓ 2,847 results
# Query with custom_metadata filter
data = datalake.list_data(
custom_metadata={"location": "factory-A"}
)
# ✓ 1,245 results
# Combine tags and dimensions
data = datalake.list_data(
tags=["production", "validated"],
limit=1000
)Support des formats image et vidéo
Ingestion des formats visuels standards
Pipeline de traitement
Génération d'embeddings et indexation en base
Requêtage de données puissant
Requêtez votre datalake de manière programmatique avec le SDK Python. Filtrez par tags, métadonnées et plus avec des type hints et de l'auto-complétion.
# Advanced data query
data = datalake.list_data(
  # Filter by tags
  tags=[
    "production",
    "validated"
  ],
  # Filter by custom_metadata
  custom_metadata={
    "location": "factory-A"
  },
  limit=1000
)

for item in data:
print(item.filename)Trouvez des images similaires instantanément
Les embeddings OpenCLIP transforment vos images en vecteurs. Recherchez par similarité, regroupez par contenu et détectez les anomalies sans écrire une seule requête.
Recherche par similarité
Image → ImagesRecherche texte vers image
Text → ImagesDétection d'anomalies
Isolation ForestFine-tunez votre propre modèle CLIP
Les embeddings génériques ne suffisent pas ? Fine-tunez un modèle CLIP sur vos propres données. La recherche et le regroupement s'améliorent considérablement quand le modèle connaît votre domaine.
DataTags et schéma de métadonnées
Organisation multi-dimensionnelle avec un système de tags flexible et un support complet des métadonnées. Structurez vos données sans déplacer de fichiers.
{
  // Location & Acquisition
  "latitude": 48.8566,
  "longitude": 2.3522,
  "altitude": 35.2,
  "acquired_at": "2024-03-15T14:32:00Z",
  "acquired_by": "drone-unit-7",
  "weather": "clear, 18C",

  // Camera & Sensor
  "focal_length": 24.0,
  "sensor_width": 36.0,
  "manufacturer": "DJI",
  "yaw": 127.5,
  "pitch": -45.0,
  "roll": 0.0,

  // Reference Fields
  "reference": "INS-2024-0042",
  "custom_id": "B-789"
}Prêt à centraliser vos données ?
Connectez votre stockage, uploadez vos données et commencez à requêter. Essai gratuit, sans carte bancaire.
Lectures associees
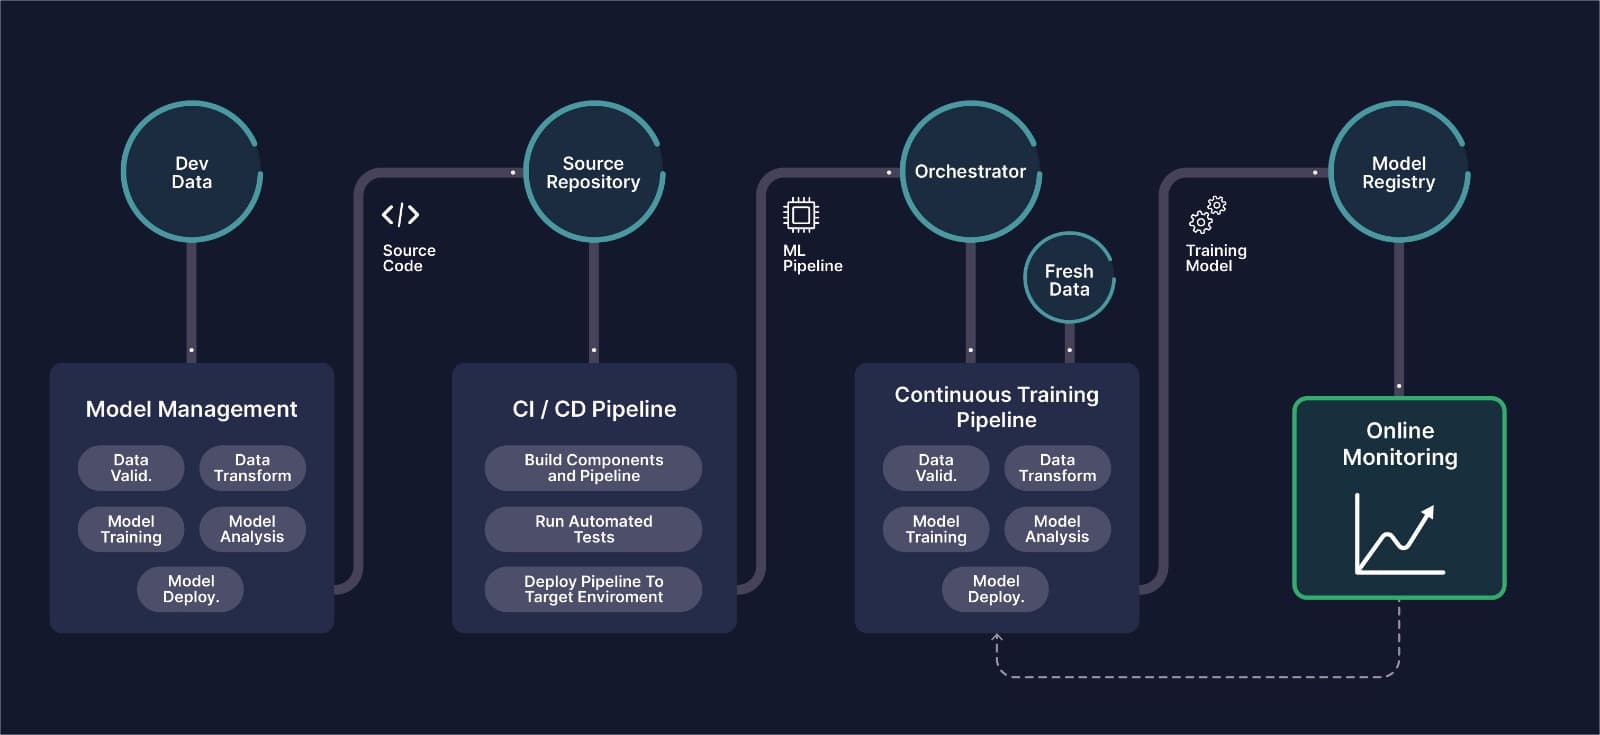
MLOps for Computer Vision: The Complete Guide
What CVOps actually means, why classical MLOps tooling breaks down on image and video data, and how the six stages of a computer vision pipeline fit together in production.
4 critères pour choisir une plateforme de gestion de données
Travailler avec de grands datasets peut être complexe. Si vous ne savez pas quels éléments considérer pour choisir une plateforme de données IA, cet article est pour vous.
La gestion des données en IA : un facteur clé de succès
Découvrez les facteurs clés de succès pour la gestion des données en IA.
Le découpage de datasets en vision par ordinateur
Découvrez le découpage de datasets, une technique utilisée pour diviser de grands ensembles de données en parties plus petites afin d'entraîner et de tester des modèles et d'améliorer leur précision.
Comment nous avons construit une fonctionnalité de recherche de similarité visuelle dans les datasets
Découvrez comment nous avons construit une fonctionnalité de recherche de similarité visuelle dans les datasets avec des embeddings et Qdrant.
Bonnes pratiques pour le versioning des données et les boucles de rétroaction
Le versioning des données est une méthodologie efficace utilisée lors de l'exécution de nombreuses expérimentations impliquant différentes techniques de traitement des données. Découvrez nos bonnes pratiques !