Vos datasets méritent un contrôle de version
Git pour vos données de vision par ordinateur. Suivez les modifications, comparez les versions et assurez la reproductibilité de chaque expérience.
Utilisé par les équipes de


Suivez chaque changement, reproduisez n'importe quel résultat
Vos datasets évoluent constamment — nouvelles images, labels corrigés, échantillons filtrés. Sans contrôle de version, vous naviguez à l'aveugle.
Snapshots immuables
Chaque version de dataset est un snapshot permanent. Référencez des états de données exacts dans vos expériences.
Gestion des labels
Créez, renommez et fusionnez les labels à travers votre dataset. Gardez votre taxonomie propre et cohérente.
Fork pour les expériences
Forkez des versions de dataset pour tester des hypothèses sans affecter les données de production.
Historique prêt pour l'audit
Journal complet de qui a changé quoi, quand et pourquoi. Parfait pour la conformité.
Chronologie des versions
InteractifTout ce qu'il faut pour gérer vos datasets
Versionnez, organisez et partagez vos datasets. Tout se connecte à vos expériences.
Contrôle de version type Git
Suivez chaque changement de vos datasets. Comparez les versions, annulez les erreurs et créez des branches pour les expériences. Traçabilité complète des données brutes aux modèles entraînés.
Organisation intelligente des données
Taguez, filtrez et découpez vos données en quelques secondes. Créez des vues personnalisées, sauvegardez des requêtes et partagez des collections. Fini la chasse dans les dossiers.
Collaboration d'équipe
Partagez les datasets entre équipes avec des permissions granulaires. Suivez qui a changé quoi, quand et pourquoi. Commentaires et revues intégrés.
Traçabilité complète des données
Tracez n'importe quelle prédiction jusqu'à ses données d'entraînement. Traçabilité prête pour l'audit. Comprenez le comportement du modèle à travers les données.
Gestion programmatique des datasets
SDK Python complet avec type hints, auto-complétion et documentation exhaustive. Intégrez les datasets directement dans vos pipelines ML.
from picsellia import Client

client = Client()
datalake = client.get_datalake()

# Get or create dataset
dataset = client.get_dataset("defect-detection")

# Create a new version
version = dataset.create_version(
  version="v3",
  description="Added edge cases"
)

# Add data from datalake
data = datalake.list_data(
  tags=["edge-case", "validated"]
)
version.add_data(data)# Label manipulation
labels = version.list_labels()
version.create_label("scratch")
# Rename a label
label = version.get_label("defect")
label.update(name="surface_defect")
# Export annotations in COCO format
version.export_annotation_file(
AnnotationFileType.COCO,
"./training_data"
)Navigateur de datasets
Structurez vos données correctement
Un bon découpage des données est crucial pour la performance du modèle. Créez des splits train/val/test reproductibles, stratifiez par classe et évitez les fuites de données.
S'intègre à votre workflow existant
Les datasets se connectent directement aux annotations, expériences et déploiements. Aucun transfert manuel.
Prêt à versionner vos datasets ?
Essai gratuit, sans carte bancaire. Commencez à versionner vos datasets dès aujourd'hui.
Lectures associees
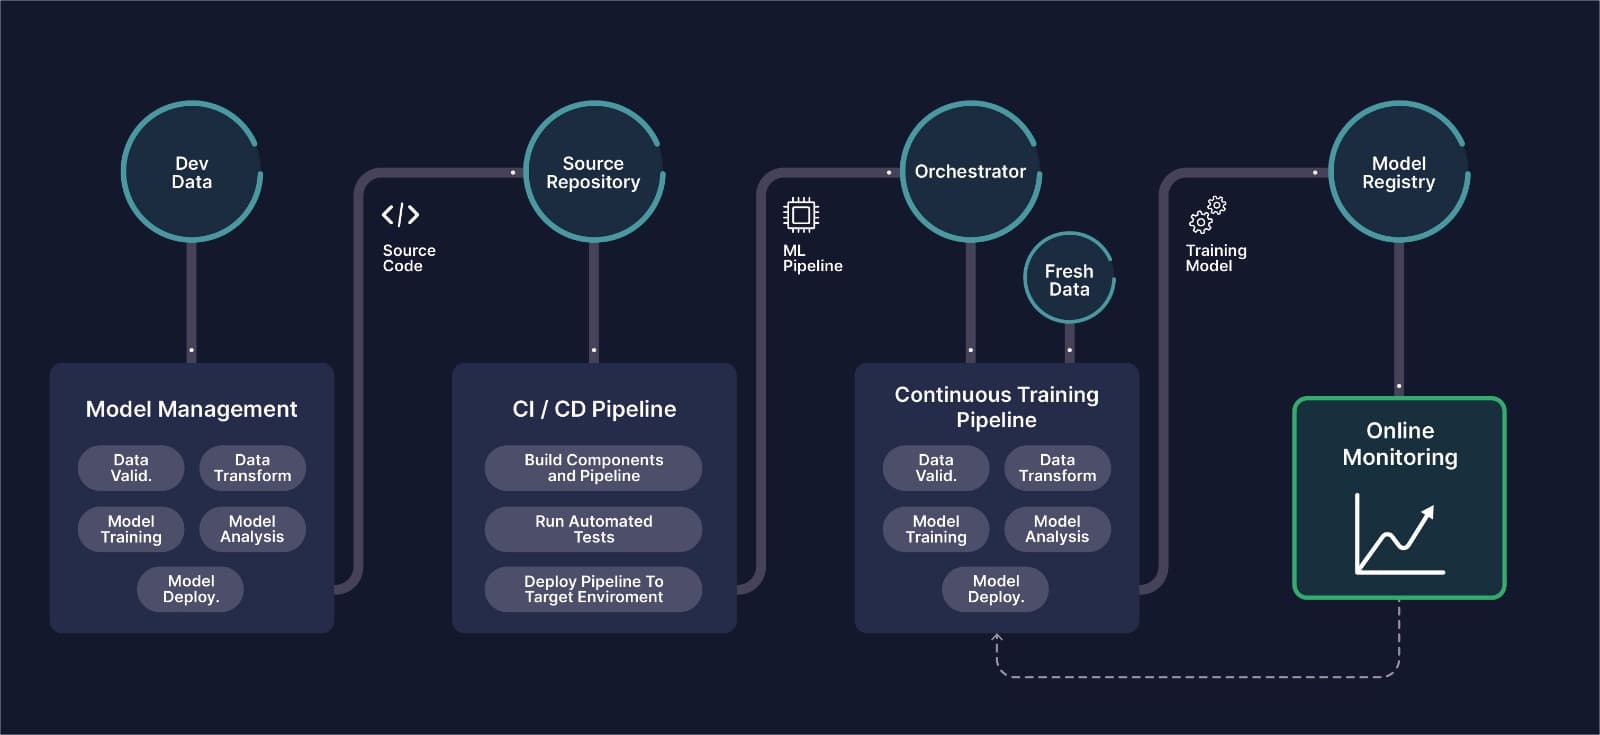
MLOps for Computer Vision: The Complete Guide
What CVOps actually means, why classical MLOps tooling breaks down on image and video data, and how the six stages of a computer vision pipeline fit together in production.
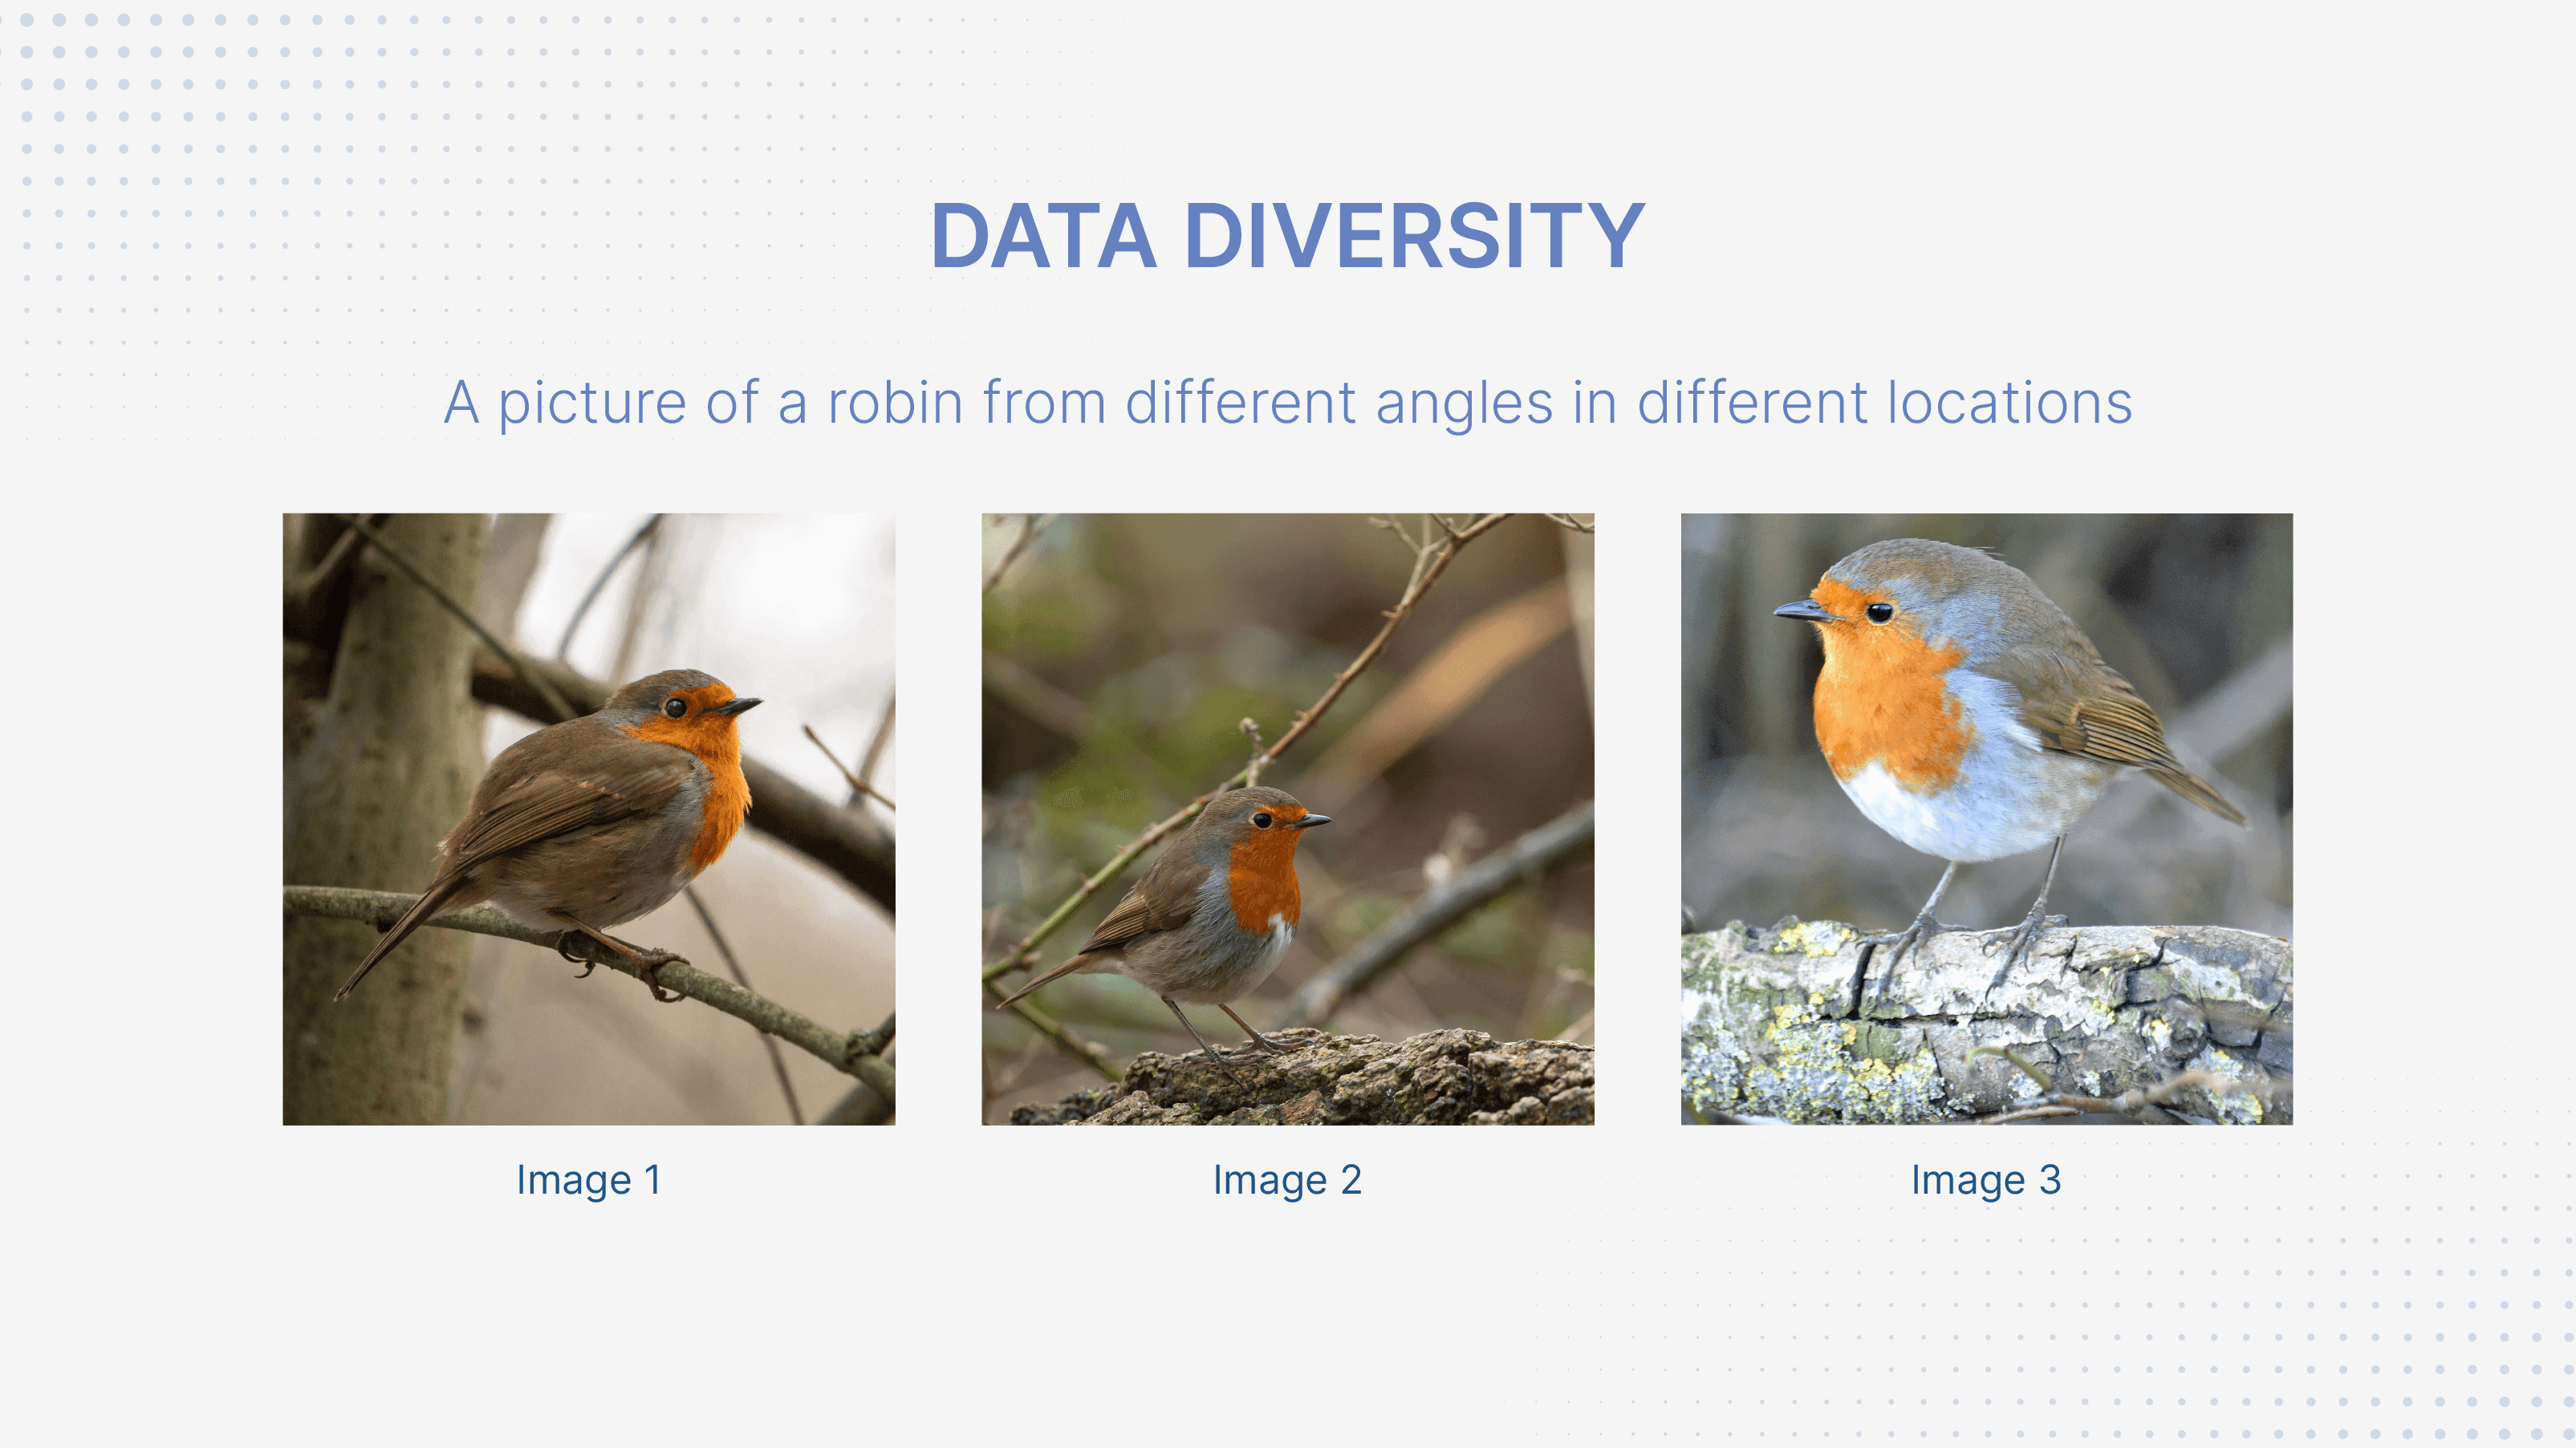
Comment garantir la qualité d'un dataset d'images pour la classification d'images
Apprenez à résoudre les principaux problèmes de qualité des datasets, et comment optimiser la qualité globale de vos modèles d'IA pour les cas d'usage de classification d'images.
Comment garantir la qualité des données – Bonnes pratiques
La curation de données est la gestion des données au sein d'une organisation afin qu'elles soient facilement disponibles dans le présent et préservées pour une utilisation future.
Comment gérer les datasets déséquilibrés en vision par ordinateur
Les datasets déséquilibrés entraînent des problèmes de précision, de surapprentissage et de biais. L'augmentation de données, la pondération des classes et la classification hiérarchique peuvent aider.
Les meilleurs datasets de détection d'objets en 2024
Vous cherchez à entraîner vos modèles de détection d'objets ? Découvrez une grande variété de datasets de détection d'objets de haute qualité pour alimenter vos projets d'IA.
Qu'est-ce que l'augmentation de données d'images ?
Pour résoudre le problème de rareté des données, nous utilisons des techniques d'augmentation de données. Mais comment augmenter des données d'images ? Nous allons l'expliquer simplement.